Showing posts with label RCM. Show all posts

Sunday, 26 April 2020

A New RCM Approach

 The aim of this article is not to introduce a new RCM methodology, there are already several and recognized, but it tries to contribute with a multidisciplinary approach that, instead of limiting it to maintenance and the ISO 55001 Asset Management standard, transform this tool into a fundamental process for making decisions related to the management of safety, environment, or compliance.

 If we do a quick review of the RCM process, as stipulated by the SAE JA1011 standard, after performing a taxonomy of assets we should define, per each component, the following concepts: 1. Operational context and Functions, 2. Functional Failures, 3. Failure Modes, and 4. Failure Effects, including in this last one, if any, adverse effects in health and safety, environment, regulatory compliance, operations, or if there isn't any risk of mention.


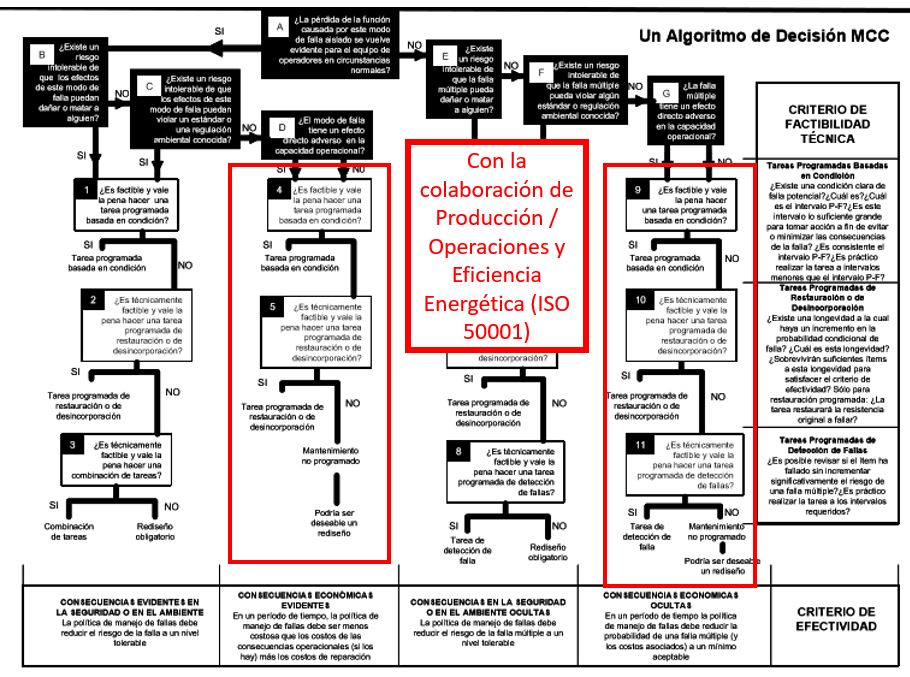
 In step 5. Failure Consequence we assign categories to the failures, consequently, we should join forces with the department concerned. In this step, we should define and assess accurately, in currency units, the consequence of the failures, considering departments of operations/production, safety management (ISO 45001, OHSAS), environment management (ISO 14001), quality management (ISO 9001, IATF 16949, IRIS), regulatory compliance (ISO 22000, NSF, ISO 27001, ISO 19600), and, even, energy management (ISO 50001) and customer satisfaction management (ISO 10001).

 The participation of these departments can be showed better using the following decision algorithm (from SAE JA1012):


 In the form that they analyze deeply the different options included in every column, assessing joined with the finance and business continuity departments different options to choose the most cost-effective solution among the failure management policies, whether 6. Scheduled Tasks or 7. One-Time Changes and Run-To-Failure.

 In cases where re-design is required the methodology proposes to consider the collaboration of Operations/Production, Engineering, and, even, Human Resources departments to rais projects of Design for Reliability D4R, Design for Maintainability, Mitigation of Effects, Changes in Operation Standards, Programs to Improve Qualifications, or, even, the Replacement of the equipment.

 In cases where the chosen option is a Run-To-Failure strategy, the methodology proposes to ensure that the Work Orders are available, including operation conditions, manpower and qualification requirements, spare-parts and special tools requirements, and an estimates time-to-repair.

 We must consider that an RCM analysis is a living program, that is to say, the analysis should be updated with the new data that we obtain day-to-day, changes in the context of operation, the market evolution, the aging of equipment and changes in performance expectations; and, finally, it should consider the technological evolution of the potential solutions.

Tuesday, 18 February 2020

Un nuevo enfoque de RCM


 Este artículo no trata de presentar una nueva metodología RCM, ya las hay muy bien diseñadas y bien conocidas, sino que trata de aportar un enfoque multidisciplinar al análisis que, en lugar de circunscribirlo a la norma ISO 55001 Gestión de Activos, convierta a esta herramienta en un proceso fundamental para la toma de decisiones relacionadas con la gestión de la seguridad, de la protección del medioambiente o del cumplimiento de regulaciones sectoriales.

 Si hacemos un repaso rápido a un procedimiento RCM, tal y como indica la norma SAE JA1011, después de realizar la taxonomía de un activo debemos definir, para cada uno de sus componentes los siguientes conceptos: 1. Contexto Operacional y Funciones, 2. Fallos Funcionales, 3. Modos de Fallo y 4. Efectos de los Fallos, indicándose en estos efectos si existen riesgos a la seguridad e higiene de las personas, al medioambiente, de incumplimiento normativo, riesgos para las operaciones o si no se aprecia ningún riesgo importante.


  Es en el paso 5. Consecuencias de los Fallos en el que categorizamos estos fallos, para lo que debemos contar con la colaboración activa de los departamentos afectados. En este paso se deben definir y valorar con exactitud, en unidades monetarias, las consecuencias de estos fallos, contando con los departamentos de operaciones/producción, seguridad (ISO 45001, OHSAS), medioambiente (ISO 14001), calidad (ISO 9001, IATF 16949, IRIS), de aseguramiento de requisitos normativos (ISO 22000, NSF, ISO 27001, ISO 19600) e incluso de eficiencia energética (ISO 50001) y de gestión comercial (ISO 10001).

 La intervención de estos departamentos se puede observar mejor sobre el siguiente árbol de decisión (tomado de SAE JA1012):


 De manera que analicen en conjunto las opciones indicadas en cada columna, evaluando con el Departamento Financiero y con Continuidad de Negocio las diferentes opciones para escoger las más costo-efectivas de entre las políticas de gestión de fallos, ya sean 6. Tareas Programadas o 7. Acciones de Una Sola Vez.

 En los casos en los que se requiera o se escoja la opción de Rediseño se propone contar con la colaboración de Operaciones / Producción, Ingeniería e incluso RRHH para plantear proyectos de Diseño para la Fiabilidad, Diseño para la Mantenibilidad, Mitigación de Consecuencias, Cambios en los Estándares de Operación, Planes de Mejora de Cualificación o, incluso, la sustitución del equipo.

 En los casos en los que se opte por una estrategia de mantenimiento correctivo, se propone asegurar que se disponen de las correspondientes Órdenes de Trabajo que incluyan las condiciones de operación, las necesidades de personal y su cualificación, los recambios y las herramientas especiales necesarias y una estimación del tiempo de reparación.

 Tengamos en cuenta que el análisis RCM está vivo, es decir, que se debe actualizar con los nuevos datos que se van obteniendo a lo largo de la vida de la instalación, que debe tener en cuenta el contexto de utilización, la evolución del mercado, el envejecimiento de los equipos y los cambios en las expectativas de su rendimiento; y, por último, se debe tener en cuenta la evolución tecnológica de las posibles soluciones.

Friday, 5 October 2018

Curso on-line de Ingeniería de Fiabilidad y RCM

 Ya éstá disponible el nuevo Curso de Ingeniería de Fiabilidad y RCM, en versión on-line y en español.

 El curso está diseñado por profesores universitarios y se realiza de una forma totalmente flexible,  al ritmo que necesite el alumno, mediante una metodología de aprendizaje novedosa, basada en la lectura de un manual (en formato e-book) con el contenido teórico de cada tema (de un máximo de 10 páginas cada uno), acompañado de la visualización de video-cuestionarios (de un máximo de 15 minutos cada uno) con contenido teórico y con casos prácticos, la realización y entrega de ejercicios prácticos y pruebas de evaluación; todo esto se acompaña de documentación adicional (que en algunos casos está en inglés) y una amplia bibliografía.

 El curso incluye el acceso a 3 horas de tutoría, a demanda del alumno, a través de videoconferencia, que quedan registradan y su visualización disponible para el alumno.


 Los contenidos, totalmente actualizados, incluyen la utilización de las normas internacionales de utilización habitual en el sector, como son las normas ISO 14224, ISO 31000, IEC/ISO 31010, SAE JA 1011, SAE J 1739 y las IEC 60812, 61025, 61078, 61508 y 61882; y los casos prácticos se resuelven utilizando aplicaciones webs gratuitas.

 El contenido incluye todos los aspectos de la ingeniería RAMS, como son:
  1. Introducción a la ingeniería RAM.
  2. Análisis de datos de vida. Distribuciones estadísticas y cálculo de tasas de fallos.
  3. Modelización de fiabilidad. Diagramas de bloques de fiabilidad RBD.
  4. Evaluación de fiabilidad. Análisis de modos de fallos y efectos FMEA y Análisis de árbol de fallos FTA.
  5. Análisis de fallos. Informe de fallos, análisis y acciones correctoras FRACAS.
  6. Análisis de mantenibilidad.
  7. Programas de mantenibilidad.
  8. Análisis de disponibilidad.
  9. Gestión de riesgos. Análisis de árbol de sucesos ETA. Análisis de peligros y operatividad  HAZOP. Nivel de integridad de seguridad SIL.
  10. Toma e intercambio de fiabilidad y mantenimiento ISO 14224. 
  11. Mantenimiento centrado en fiabilidad RCM.
  12. Fiabilidad a través de los operarios ODR. 
  13. Consideraciones económicas. 
  14. Aplicaciones de fiabilidad. Priorización de tareas. Gestión de recambios. Análisis tensión - resistencia. Gestión de garantías.
  15. Testeabilidad.
  16. Ensayos de fiabilidad. 
  17. Incremento de fiabilidad.
  18. Gestión de proyectos de fiabilidad.
 Superar el curso con una calificación superior al 80 % en todas las pruebas de evaluación permite obtener un Certificado de aprovechamiento del curso, bilingüe español - inglés.

 El coste del curso es de 600.00 € (USD 690.00 ; GBP 540.00), mediante transferencia bancaria o mediante PayPal. Tras lo cual AlterEvo Ltd. envía al alumno las claves de acceso a las carpetas de documentación y a los video-cuestionarios, estas claves tienen una validez de 12 meses.

Monday, 9 May 2016

Book a Free Consultation / Solicite una Consulta Gratuita

 Do you need consulting about Asset Management or Design for Reliability (D4R)? Now you can book a free consultation about the following topics:

- Asset Management (ISO 55000 / PAS-55)

- Operational Excellence, by Lean Manufacturing and TPM.

- Maintenance, Reliability and Reliability Centered Maintenance (RCM).

- Risk based Maintenance and Risk Assessment.

- Design for Reliability (D4R).

- Lubrication, Reliability Centered Lubrication.

- Failure Analysis and Forensic Engineering (Mechanical Engineering).

 Just click I Want a Free Consultation and send us an e-mail with your name, company name, some details about your consultation, and days and times you are available, so we arrange a 45 minutes meeting, by Skype, Hangouts or FaceTime, with one of our Chartered Engineers.


¿Necesita consultoría sobre Gestión de Activos o Diseño para Fiabilidad (D4R)? Ahora puede solicitar una consulta gratuita sobre los temas siguientes:

- Gestión de Activos (ISO 55000 / PAS-55)

- Excelencia Operacional, mediante Lean Manufacturing y TPM.

- Mantenimiento, Fiabilidad y Mantenimiento Centrado en Fiabilidad (RCM).

- Mantenimiento basado en Riesgo y Evaluaciones de Riesgo.

- Diseño para la Fiabilidad (D4R).

- Lubricación, Lubricación Centrada en Fiabilidad.

- Análisis de Fallos e Ingeniería Forense (Ingeniería Mecánica)

 Solamente haga click en Quiero una Consulta Gratuita y envíenos un e-mail indicando su nombre, el nombre de su compañía, detalles sobre la consulta, y su disponibilidad, para organizar una reunión de 45 minutos, por Skype, Hangouts o FaceTime, con uno de nuestros ingenieros colegiados.

Thursday, 3 December 2015

RCM 10: Learning Lessons

A lot of things can go wrong during the implantation of an RCM Project, in the same way, that other projects, recording the acquired knowledge-based in experience is important to be exploited in the future.

Some of the lessons that I have learned during my last projects are listed below.

1.   Project scope. Usually, this item is a source of conflicts among the stakeholders, this is due they have got different experiences in RCM, since every project is different, to find disagreements is normal.

The problem is increased when we find external staff because it produces a project cost increase. Well-Defined project scope is important to avoid misunderstandings and problems among the stakeholders, an increase of period and costs.


2.  Level of detail. The level of detail must be defined, it should include as the analysis of equipment as the description of tasks and actions to implant as a result of the RCM analysis.

A level of detail too low makes the analysis useless because it doesn’t define the results; a level of detail too high is also useless because the result will be too long and costly, and difficult to implant.

Regarding the analysis of equipment, in accordance with ISO 14224 standards, to analysis up the level of components is recommended, the level of an element only is interesting for equipment with a special complexity.

Regarding tasks description, it is sufficient to be explicit enough for maintenance operators to identify them right, to replace work orders is not necessary. If actions are redesign to define a target, delivery and cost is enough.

3.  Expectations of stakeholders. Different expectations among stakeholders is usual, to solve this problem is possible by a good definition of goals.

Usually, stakeholders consider the result of an RCM analysis is a reduction of maintenance costs, an increase of the number of tasks, the elimination of failures or a full replacement of preventive maintenance to on-condition maintenance.

We must consider RCM is a methodology to optimize maintenance, increasing reliability with minimum cost, so we should neither predict outcomes nor enforce results.   

4.  Are we doing true RCM? Usually we believe we are doing RCM but it is not true, RCM is not a way to justify the current maintenance plan, to perform all the maintenance tasks recommended by the OEM, or to implant a full on-condition maintenance plan.

We should consider that RCM is to follow a structured procedure, by using logic trees, to obtain a maintenance plan that provides maximum reliability with minimum cost.

5.   Training of stakeholders. RCM training to all stakeholders is the best way to avoid false expectations and to ensure we are doing true RCM.

Training must be at different levels of intensity depending on the degree of involvement of stakeholders; it must provide a culture of reliability in the organization and make clear goals, scope, level of detail and possible results. Training should provide deep knowledge of the procedure to members of analysis and implantation teams.
To ensure the efficient fulfillment of targets, to perform training at the beginning of the Project is recommended.


6.  Continuous improvement. The RCM maintenance plan is a living paper; it must be updated continuously, so to try to design an RCM plan for several years is a mistake.

The plan must be updated when the operation conditions, the financial environment, the product sale price, or the raw materials and energy cost change, even when the condition monitoring techniques develop.

Also, all the new functional failures, that are not included in the RCM plan, and regular system failures must be analyzed by RCA and must be included in the maintenance plan. 


Friday, 20 November 2015

RCM 10: Lecciones Aprendidas

Muchos factores pueden salir mal durante la implantación de un proyecto de RCM, al igual que en otros tipos de proyectos es importante registrar las lecciones aprendidas, es decir del conocimiento adquirido a lo largo del proceso, normalmente en base a errores, para ser aprovechados en futuros proyectos.

A continuación incluyo algunos de las lecciones que he aprendido en la implantación de proyectos de RCM:

1. Alcance del proyecto. Es un punto que habitualmente causa conflictos entre los implicados en el proyecto, esto se debe a que tienen diferentes experiencias en RCM, y puesto que cada proyecto es diferente, es habitual que aparezcan discrepancias.

Este problema se ve incrementado si hay participación de externos, ya que implica costes adicionales al proyecto. Es muy importante definir correctamente el alcance del proyecto con los implicados, esto evitará malentendidos, aumentos de plazos y de costes.


2.   Grado de detalle. Se debe definir el grado de detalle, esto incluye tanto el detalle en el análisis de los equipos como en la descripción de las tareas y acciones que se van a implantar como consecuencia de los análisis.

Un grado de detalle demasiado bajo hace el análisis inservible por no concretar los resultados, un grado de detalle demasiado elevado lo hace inútil por dar como resultado un plan demasiado extenso, largo y costoso de realizar.

En lo referente al análisis de los equipos, siguiendo la norma ISO 14224, es recomendable analizar a nivel de componentes, dejando el  nivel de elementos para equipos especialmente críticos. En cuanto a la descripción de tareas, basta con que sean lo suficientemente precisas para que los operarios de mantenimiento las identifiquen correctamente, no es necesario que sustituyan a una orden de trabajo. Si se trata de una acción que supone un rediseño, es suficiente con que indique el objetivo, plazo y presupuesto de este.

3. Expectativas de los afectados. Es normal que los afectados tengan diferentes expectativas, en gran parte se puede solucionar este problema con una buena definición de los objetivos.

A menudo, los afectados creen que el resultado del análisis RCM es una reducción de los costes de mantenimiento, un incremento del número de tareas, la eliminación total de los fallos o la total sustitución del mantenimiento preventivo por predictivo.

Debemos tener en cuenta que RCM supone una optimización del mantenimiento para aumentar la fiabilidad al menor coste, por lo tanto no podemos predecir ni debemos imponer los resultados.   

4.  ¿Estamos haciendo realmente RCM? A menudo pensamos que estamos haciendo RCM pero no es así, no es RCM buscar una justificación al plan de mantenimiento actual, utilizar todas las tareas de mantenimiento recomendadas por el fabricante del equipo, o implantar mantenimiento predictivo.

Debemos tener claro que RCM supone seguir un procedimiento estructurado para, mediante árboles de decisión, producir un plan de mantenimiento que proporcione la máxima fiabilidad al menor coste.

5.   Formación de los afectados. Formar en RCM a todos los afectados por el proyecto es la mejor forma de evitar falsas expectativas y asegurar que realmente se está haciendo RCM.

La formación puede tener diferentes niveles de intensidad según el grado de implicación de los afectados, pero debe al menos servir para crear una cultura de fiabilidad y dejar claros los objetivos, alcance, grado de detalle y posibles resultados; llegando hasta un conocimiento profundo del procedimiento en el caso de los miembros de los equipos de análisis e implantación.

Para que cumpla estas funciones eficazmente, se recomienda realizar la formación al principio del proyecto.


6.  Mejora continua. El plan de mantenimiento RCM es un documento vivo que debe actualizarse continuamente, es un error pretender realizar un estudio que sirva durante una serie de años.

El plan debe actualizarse según se modifiquen las condiciones de trabajo, el entorno económico, los precios de venta del producto producido y los costes de materias primas y energía o, incluso, evolucionen las tecnologías de técnicas predictivas.

Thursday, 5 November 2015

RCM 9: If something goes wrong.

Once we designed and implanted our Reliability-Centered Maintenance program we can see that failures still remain in our equipment, some failures are unplanned and others are planned but our RCM plan is not able to avoid. What can we do?

We can repair the failure as soon as possible, but probably the failure occurs often, so we don't solve anything.

The solution is to perform a Root Cause Analysis - RCA that allows us to know the root cause of failures, so we can avoid the cause and prevent the failure occurs again. Exactly RCA is a process to isolate factors to produce failure and determine optimal actions to ensure the failure is not being repeated over again.

Several techniques can be used to perform Root Cause Analysis, from the easiest 5 Whys, of Lean Manufacturing methodology, that can be applied by the machine operators, to many complex techniques such as Events and Causal Charting, Change Analysis, Fishbone (Ishikawa) Diagrams, Fault Tree Analysis (FTA) or Failure Modes and Effects Analysis (FMEA) completed with interviews and tests.

Whatever the methodology, an effective process must meet the following criteria: define the problem, establish relationships between cause and problem, present evidence, explain how to prevent recurrence of the problem, assess measures and facilitate the writing of result reports. Methodologies listed before not always provide an acceptable response to these criteria, so the results are unsatisfactory.

Dean L. Gano, the inventor of Apollo RCA, proposes an evolution of this methodology in his last book RealityCharting – Seven Steps to Effective Problem-Solving and Strategies for Personal Success, it is based in seven steps:

1.      Define the problem. It must include answers related to What is the problem, When did it happen, Where did it happen and what is the significance of the problem, best in Dollars/Pounds/Euros.

2.  Determine the causal relationships. When we have identified the problem, we must identify a minimum of two causes, one of which should be an Action and other a Condition. In each cause, we must identify new causes or a reason to conclude the analysis line.
  
3.   Provide a graphical representation. To draw a graphic chart to show the logic succession of events and causes, it does easier to find relations among them.

4.  Provide evidence, of each cause, best if we have photos, data and test results to confirm both events and causes.

5.      Determine if causes are sufficient and necessary. It means to confirm the event should not occur without the cause, and to confirm the event doesn't need more causes.

6.    Identify effective solutions. When we have identified the sufficient and necessary causes we can propose solutions, they must meet the following criteria: Prevent recurrence, Be within your control, Meet your goals and objectives, and Not cause other problems that you are aware of. We assess solutions by costs-benefits analysis.

Monday, 19 October 2015

RCM 9: ¿Y si algo sale mal?

Una vez que hemos diseñado e implantado nuestro plan de Mantenimiento Centrado en Fiabilidad RCM nos encontraremos con que sigue habiendo fallos en los equipos, algunos que no habíamos previsto y otros que nuestro plan no es capaz de solucionar. ¿Qué podemos hacer entonces?

Podemos reparar el fallo lo antes posible, pero lo más probable es que el fallo se reproduzca, por lo que no solucionamos nada.

La solución es realizar un Análisis de Causa Raíz RCA que nos permita conocer la causa raíz del fallo, de manera que podamos solucionar esa causa y consigamos que el fallo no se vuelva a producir. Eso es exactamente un RCA, un proceso que permite aislar los factores que producen un fallo, una vez que los hemos identificado podremos determinar las acciones óptimas para asegurar que alguno de los factores necesarios no se vuelvan a repetir, de manera que la reproducción del fallo es imposible.

Existen varias técnicas, más o menos normalizadas, que pueden ser de utilidad para realizar análisis de causa raíz, desde la más sencilla 5 Whys (o 5 Porqués) tomada de la metodología Lean, que pueden aplicar los propios operarios en el momento de detectar el fallo, a metodologías más complicadas que requieren formación concreta, como pueden ser Diagramas de Causa y Efecto, Análisis de Cambios, Diagramas Fishbone (o Ishikawa), Análisis de Árbol de Fallos (FTA) o Análisis de Modos de Fallo y Efectos (FMEA), combinados con entrevistas y ensayos.

Cualquiera que sea la metodología que utilicemos debe aportar respuestas a las necesidades de definir el problema, definir todas las causas, proporcionar relaciones entre las causas y el problema, definir evidencias, explicar cómo evitar la recurrencia del problema, valorar las medidas preventivas y facilitar la realización de un informe de resultados. Las metodologías que hemos enumerado antes no siempre consiguen dar una respuesta aceptable a estos apartados, lo que puede hacer que el resultado no sea satisfactorio.

Dean L. Gano, creador de la metodología Apollo, propone una evolución de este método en su libro RealityCharting – Seven Steps to Effective Problem-Solving and Strategies for Personal Success, basada en siete pasos:

1.   Definir el problema. Que debe incluir respuestas a cuál es el problema, cuándo ocurre, dónde ocurre y cuál es el impacto del problema, preferiblemente valorándolo en Euros.

2.  Determinar las relaciones causales. Una vez que tenemos identificado el problema debemos identificar al menos dos causas, de las cuales al menos una será una condición del equipo y al menos una será una acción sobre el equipo, para cada causa debemos buscar nuevas causas o una razón, que finalizaría esa línea del análisis.
  
3.   Proporcionar una representación gráfica. Consiste en mostrar la sucesión de sucesos y causas de forma gráfica, de manera que se puedan ver claramente las relaciones entre ellas.

4.    Proporcionar evidencias, de cada una de las causas, mejor si tenemos fotografías, datos objetivos o pruebas que confirman los sucesos o las causas.

5.  Determinar si las causas son suficientes y necesarias. Es decir, confirmar que el suceso no puede ocurrir si no ocurren esas causas, y si no es necesario más causas.

6.   Identificar soluciones efectivas. Una vez identificadas las causas necesarias y suficientes se actúan sobre ellas, de manera que se prevenga la recurrencia, se controle el equipo, este cumpla con nuestros objetivos y no cause otros fallos. La efectividad de las medidas se evalúan comparando su coste con el coste del fallo.

Thursday, 8 October 2015

Dairy Industry Crisis: Technical Solutions

 The European dairy industry is suffering a deep crisis during the last months due to the low prices of sales, under the production costs.

 According to the European Commission, the crisis has been driven by Russia's trade ban on Community food industry, added a demanding fall of milky products in China P.R. and other BRICS countries to a lesser extent, and a slight increase of the world production especially emphasizing Australia (2.5 %), USA (1.6 %), New Zealand, world's largest producer, (0.9 %) y the European Union (0.8 %).


 Summarizing, there has been a temporary drop in demand that joined a slight increase in production.

 The practical impact is the milk price is between 15 % and 35 % (depends on the EU area) under a price to give profitability enough to the producers.

What solutions can be applied?

 Both, the dairy producer associations and European Union governments propose the following measures:
  • Setting minimum retail prices.
  • Re-introduction of production quotas.
  • Financial grant, to compensate for the drop in profitability. 
  • Encourage innovation and develop new dairy products, to consume milk production.
  • Creation of new cooperatives and associations, to apply economy of scale.
 Innovation and development of new dairy products are an excellent solution, it must be carried out at all times, but due to its high risk, high cost and high period of phasing, it doesn´t look the best short-term solution.

 Creation of cooperatives and associations will reduce costs and increase efficiencies, but supposes a short-time staff reduction by duplicities elimination.

 Regarding setting prices, re-introduction of quotas and financial grants, they don't suppose an improvement of producer's productivity, so the producers will be grants dependant and will lose market share.

An engineering solution.

 We can define productivity as a ratio of outputs (milk production) and inputs (resources needed for the production).

Productivity = Actual Outputs / Actual Inputs

 Let's analyze each term.

Actual Outputs: It's the result to multiplying production Capacity, Availability of the process (ratio of gross operating time and available production time), Performance of the process (ratio of net operating time and gross operating time), and Quality of the process (ratio of valuable operating time and net operating time).


In accordance with Lean Manufacturing methodology, the result of multiplying Availability, Performance, and Quality is defined as Overall Equipment Effectiveness (OEE):

Actual Outputs = Capacity * OEE

Actual Inputs: It's the result of the addition of human resources and physical resources; physical resources are the addition of Acquisition Costs, Operation Costs, Maintenance Costs, and Disposal Costs.

Resources = Human Resources + Acquisition Costs + Operation Costs + Maintenance Costs + Disposal Costs

 Therefore, to improve productivity is possible by the OEE increase, Acquisition, Operation, Maintenance and Disposal Costs; without increase the Capacity or reduce Labor Force Costs.

 To implant Lean policies, as Value Stream Mapping and pull system to eliminate wastes, to increase availability by Kanban and reduce human errors by Poka-Yoke allow increasing dramatically the real production without big capital investments.

 On the other hand, to implant a Physical Asset Management plan allows the physical resources optimization by implanting specific measures as Reliability Assurance programs and Reliability Centered Maintenance (RCM), taking into consideration the implantation risk.


 A sustainable solution.

 The implantation of both Lean and Physical Asset Management results in a quick rise of productivity, without the need for a large investment, without reducing the labor force, and controlling the risk associated.

 It provides a sustainable solution because it is focused on reducing costs; consequently, it increases competitiveness, at the same time increases production, and allows to rise of the market share and business profitability, releasing resources that may dedicate themselves to research, development, and innovation.